HDF5 データセット
HDF5(Hierarchical Data Format version 5)は、グループとデータセットで階層的なデータを整理します。プラットフォームはアノテーション済みの録画データを HDF5 としてエクスポートし、プラットフォーム外の学習フレームワークが読み取れるようにします。
定義
| 項目 | 説明 |
|---|---|
| 保存単位 | 単一の .hdf5 ファイルで、ファイル内はグループとデータセットからなるツリーです |
| グループ化 | エクスポートパラメータに従って元ファイルをグループ化し、各グループを 1 つの chunk_NNN.hdf5 に書き込みます |
| episode | アノテーションタスクが /data 配下の 1 つのグループに対応します |
| フレームのアラインメント | 同じ episode 内の各データセットはフレームインデックスで 1 対 1 に対応します |
ルールと処理フロー
取り込みとインポート
プラットフォームは前処理段階で、次の提供元の HDF5 録画を MCAP に変換してから取り込みます。取り込み後はプラットフォーム内で確認とアノテーションができ、再度 HDF5 としてエクスポートできます。
| 提供元 | 前処理の動作 |
|---|---|
| Agilex | io_hdf5agilex2mcap |
| Realman | io_hdf5realman2mcap |
| Dobot | io_hdf5dobot2mcap |
| Limx | io_hdf5limx2mcap |
| Unix | io_hdf5unix2mcap |
エクスポートルール
| ルール | 説明 |
|---|---|
| グループ化 | chunk_size 個の元ファイルごとに 1 つのチャンクファイルにまとめ、チャンク番号は 1 から始めて 3 桁でゼロ埋めします |
| サンプリング | 書き込み前に hz に従って各メッセージを等間隔でサンプリングします |
| episode の分割 | sidecar JSON の各 subtasks 項目を 1 つの data/episode_NNN グループに書き込みます。sidecar JSON がない場合は録画全体を 1 つの episode として書き込みます |
| 変換元 | MCAP の入力は io_mcap2hdf5、Agibot の解凍ディレクトリは io_agibot2hdf5 を通します |
| マージ | 変換結果は merge_chunks.py が chunk_size に従ってマージし、チャンク番号は連続を保ちます |
| アーカイブ | すべてのチャンクファイルを 1 つのアーカイブにまとめ、既定は tar.gz です |
エクスポート結果
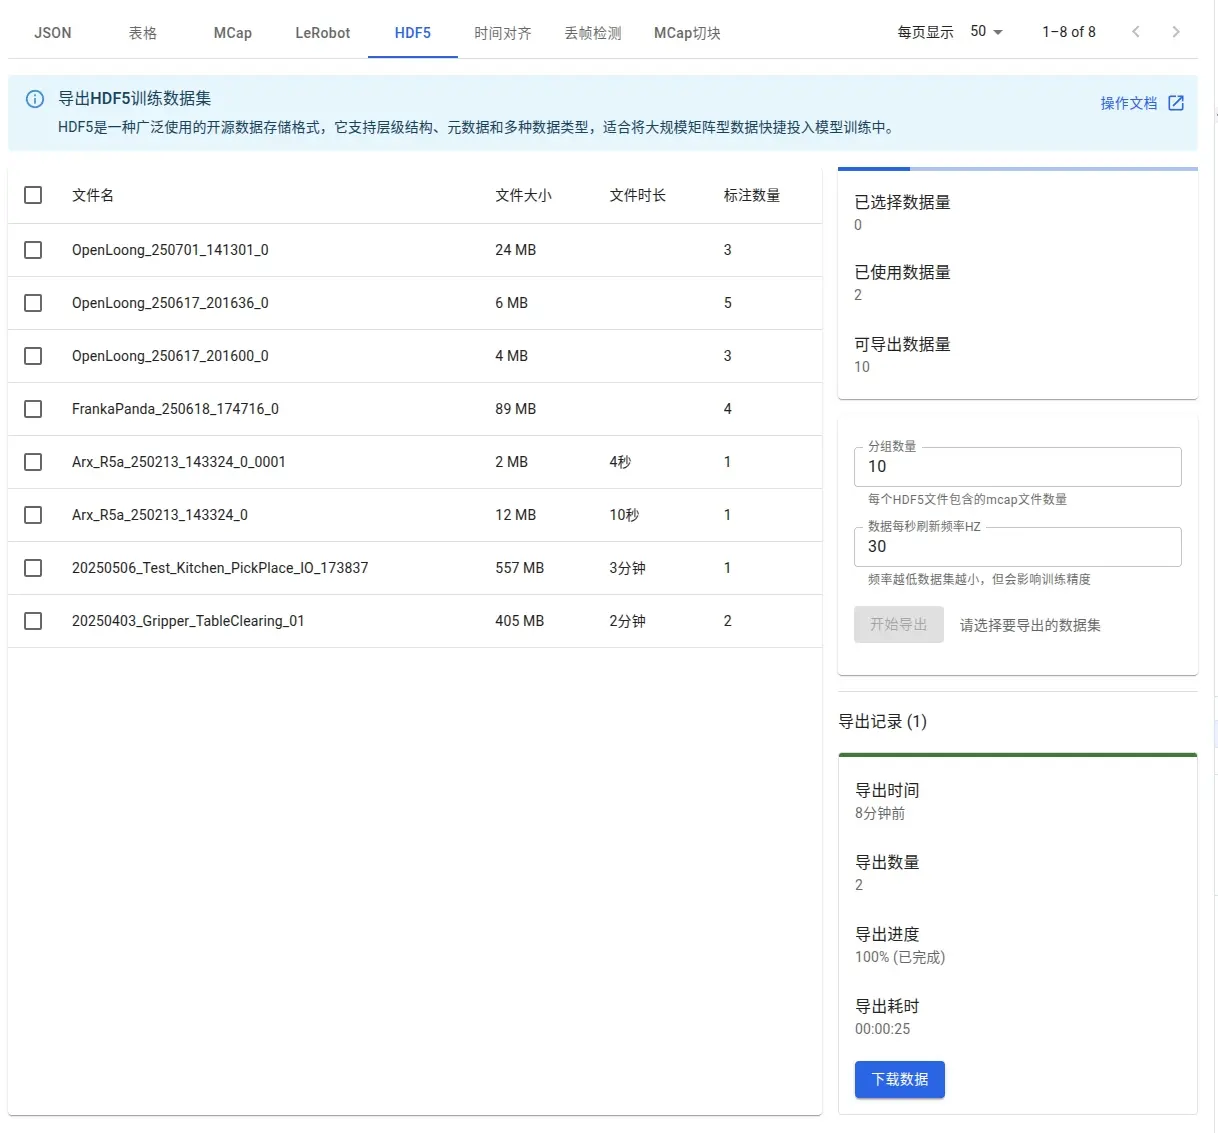
エクスポートタスクが完了すると、エクスポート記録でステータスを確認し、アーカイブをダウンロードできます。

パラメータとフィールド
エクスポートパラメータ
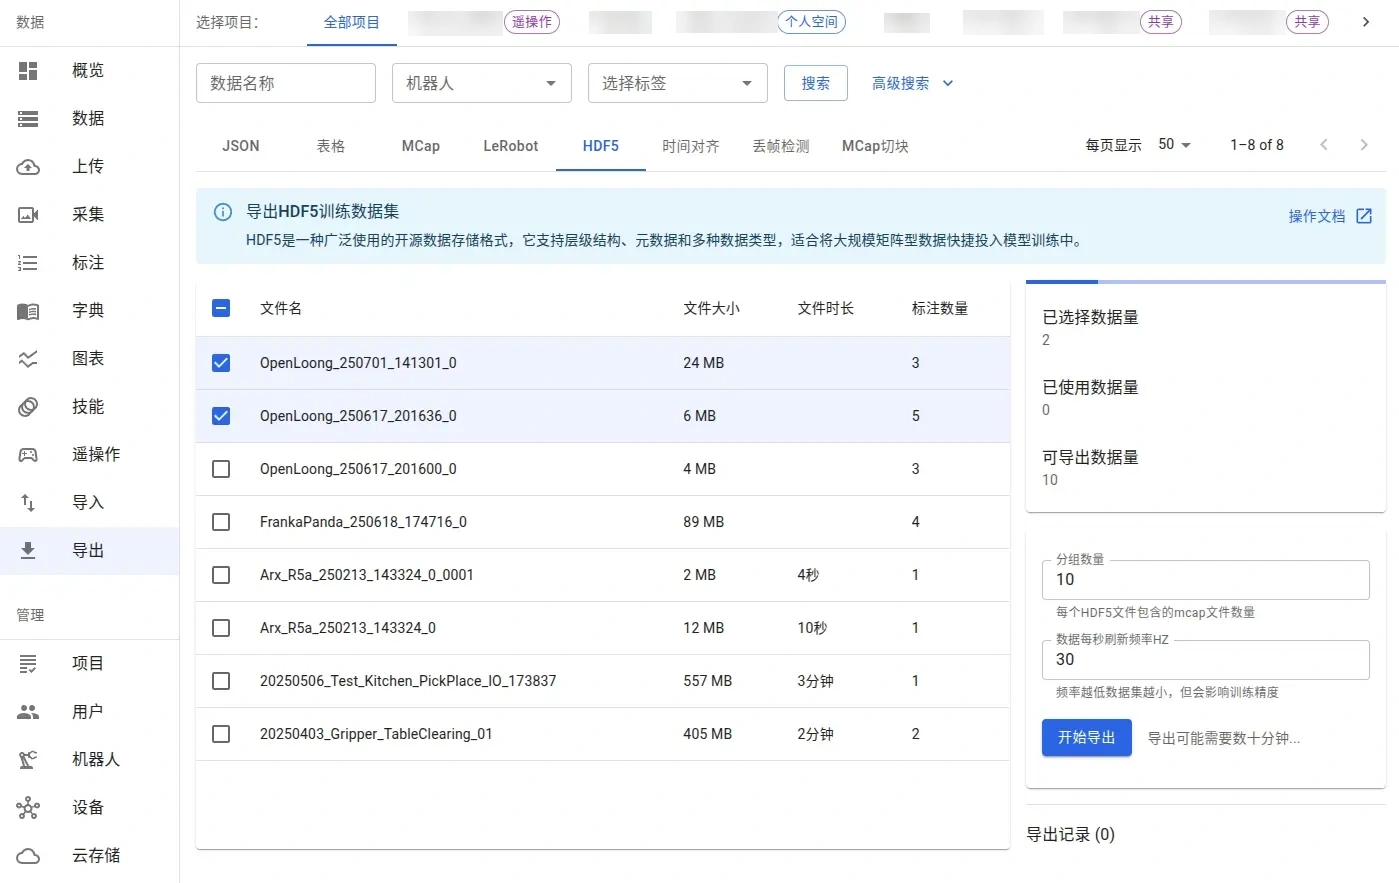
エクスポート画面は次のパラメータを提供し、書き込みは変換コマンドの --chunk_size と --hz に基づきます。
| パラメータ | 型 | 必須 | 既定値 | 値の範囲 | 説明 |
|---|---|---|---|---|---|
chunk_size(グループ数) | 整数 | はい | 10 | 1–100 | 1 つの HDF5 ファイルに含める元ファイルの数です。1 にすると元ファイルとチャンクファイルが 1 対 1 に対応します |
hz(データを 1 秒ごとに更新する頻度) | 整数 | はい | 30 | 1–60 | 書き込み前に各メッセージを等間隔でサンプリングします。サンプリングのフレームグリッドは 30 Hz に固定され、サンプリング周波数は各フレームで取得するメッセージだけを変えます |
データの選択とパラメータのパネルは下図のとおりです。
ディレクトリ構造
chunk_001.hdf5
├── data/
│   ├── episode_001/
│   │   ├── action
│   │   ├── observation.gripper
│   │   ├── observation.images.<camera>
│   │   └── observation.state
│   └── episode_002/
└── meta/
各 episode グループの下にフィールドごとにデータセットを書き込み、形状はフレーム数 T で始まります。
| データセット | 形状 | 内容 |
|---|---|---|
action | (T, D) | 送出する関節コマンド |
observation.state | (T, D) | 関節の観測値 |
observation.gripper | (T, 2) | グリッパの観測値で、[right_gripper, left_gripper] と定めます |
observation.images.<camera> | (T,) | 各フレームに JPEG 符号化画像を 1 枚。要素は uint8 の可変長配列です |
各 episode グループには次の属性が付きます。
| 属性 | 型 | 説明 |
|---|---|---|
task | 文字列 | アノテーションされた自然言語のタスク説明 |
task_zh | 文字列 | タスク説明の中国語テキスト |
score | 数値 | 動作品質スコアで、既定は -1 です |
/meta グループの内容は入力の提供元によって異なります。
| meta の内容 | 提供元 | 説明 |
|---|---|---|
| 特徴量メタデータ | io_mcap2hdf5 | 各フィールドの dtype、shape、names を meta グループ属性に書き込みます |
| ロボットの型番と URDF | io_agibot2hdf5 | meta.robot_type 属性と meta/urdf |
| カメラの内部・外部パラメータ | io_agibot2hdf5 | meta/camera/<camera>/intrinsic と extrinsic(JSON テキスト) |
読み取り方法
h5py はチャンクファイルをそのまま読み取れます。
import h5py

with h5py.File("chunk_001.hdf5", "r") as f:
    episodes = list(f["data"].keys())          # episode_001, episode_002, ...
    episode = f["data/episode_001"]
    task = episode.attrs["task"].decode()      # natural language task
    score = episode.attrs["score"]             # action quality score
    actions = episode["action"][:]             # (T, D)
    state = episode["observation.state"][:]    # (T, D)
    frames = episode["observation.images.camera_01"][:]  # JPEG bytes per frame
根拠
| 項目 | 値 | 根拠 |
|---|---|---|
| チャンクの命名 | chunk_NNN.hdf5 | tools/mcap2hdf5/mcap2hdf5.py、tools/agibot2hdf5/convert_to_hdf5.py |
chunk_size の既定値 | 10 | tools/mcap2hdf5/mcap2hdf5.py(--chunk_size) |
hz の既定値 | 30 | tools/mcap2hdf5/mcap2hdf5.py(--hz) |
| 画面の値の範囲 | chunk_size 1–100、hz 1–60 | app/app/(dashboard)/(data)/export/hdf5/HDF5ExportClient.tsx |
| episode の命名と属性 | episode_NNN、属性は task、task_zh、score | tools/mcap2hdf5/mcap2hdf5.py、tools/agibot2hdf5/convert_to_hdf5.py |
| 画像の符号化 | JPEG、uint8 の可変長配列 | tools/mcap2hdf5/mcap2hdf5.py、tools/agibot2hdf5/convert_to_hdf5.py |
| アーカイブ形式 | tar.gz | worker/src/workers/export.ts |
| 変換イメージ | io_mcap2hdf5、io_agibot2hdf5 | worker/src/docker-check.ts |
使用上の制限
HDF5 データのインポートとエクスポートは次の既存の境界に制約されます。
| 項目 | 制限 | 説明 |
|---|---|---|
| 取り込み元 | Agilex、Realman、Dobot、Limx、Unix | 上記の提供元にのみ HDF5 から MCAP へのコンバータがあり、その他の HDF5 録画はインポートできません |
| グループ数 | 1–100 | 各チャンクファイルに含める元ファイルの数で、画面で指定できる値の範囲です |
| サンプリング周波数 | 1–60 Hz | サンプリングのフレームグリッドは 30 Hz に固定され、サンプリングは各フレームで取得するメッセージだけを変えます |
| episode の分割 | subtasks 項目ごとに 1 つの episode | sidecar JSON がない場合は録画全体を単一の episode とします |
| デコード可能なメッセージの欠落 | ファイルの変換に失敗します | 画像と関節のメッセージがどちらも欠落している場合、そのファイルはエラーとなりスキップされます |
| 画像の符号化 | JPEG に固定 | 各フレームを JPEG で書き込み、符号化は変更できません |
| アーカイブ形式 | tar.gz | すべてのチャンクを 1 つのアーカイブにまとめます |