模型训练
训练页面在浏览器内完成策略模型的训练任务创建、参数配置、过程监控与检查点管理。训练任务的执行由训练服务调度,产出可部署为推理服务的检查点。
适用角色与前提
角色与权限
| 角色 | 可执行操作 | 必需权限 |
|---|---|---|
| 管理员 | 创建、查看、停止、删除训练任务;管理训练额度 | 「查看训练」、「创建训练任务」 |
| 项目经理 | 创建、查看、停止、删除训练任务 | 「查看训练」、「创建训练任务」 |
菜单入口为模型 → 训练。模块权限的配置方式见模块权限。
使用前提
| 项 | 要求 |
|---|---|
| 训练服务 | 训练服务已部署并可访问 |
| 训练数据 | 已导出的 LeRobot 导出记录、已上传的 LeRobot 数据集、可访问的下载链接,或 HuggingFace 数据集之一 |
| 数据集版本 | LeRobot v2 或 v3;spirit-v1.5 另支持 robochallenge |
| 训练位置 | 管理员已配置本机 GPU 服务器或远程训练节点 |
| GPU 资源 | 本机训练需可用 GPU;groot 仅支持 Nvidia Ampere 及以上型号 |
| 训练额度 | 次数额度与时长额度未用尽,额度由管理员在额度管理中授予 |
| 权限 | 「创建训练任务」 |
操作步骤
支持的模型与框架
平台注册 11 个可训练策略模型。每个模型支持的框架与数据集版本如下。
| 模型标识 | 支持框架 | 默认框架 | 支持数据集版本 |
|---|---|---|---|
act | act、lerobot | act | v2、v3 |
diffusion | lerobot | lerobot | v2、v3 |
groot | lerobot | lerobot | v2、v3 |
pi0 | lerobot、jax | lerobot | v2、v3 |
pi05 | lerobot、jax | lerobot | v2、v3 |
reward_classifier | lerobot | lerobot | v2、v3 |
sac | lerobot | lerobot | v2、v3 |
smolvla | lerobot | lerobot | v2、v3 |
spirit-v1.5 | spirit | spirit | robochallenge、v2、v3 |
tdmpc | lerobot | lerobot | v2、v3 |
vqbet | lerobot | lerobot | v2、v3 |
框架说明如下。模型被管理员通过名称或框架禁用后不出现在训练页。
| 框架标识 | 说明 | 适用模型 |
|---|---|---|
lerobot | HuggingFace 机器人学习框架,基于 PyTorch | 除下述专用框架外的全部模型 |
jax | JAX 计算框架 | pi0、pi05 |
act | ACT 专用训练栈 | act |
spirit | Spirit 官方训练栈 | spirit-v1.5 |
创建训练任务
- 进入模型 → 训练,点击「创建训练」。
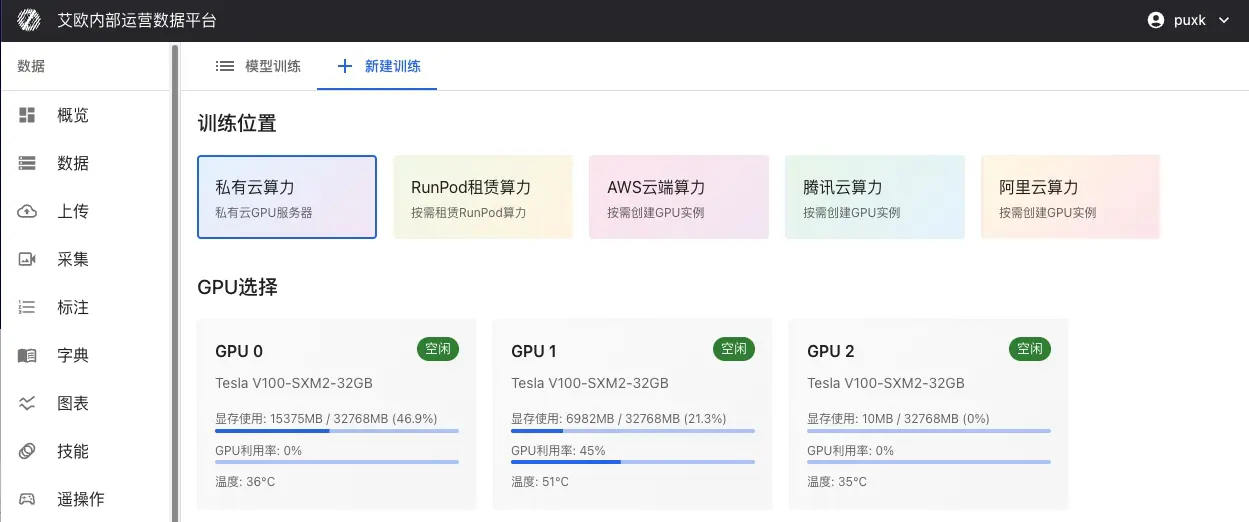
- 选择训练位置;选择本机 GPU 服务器时,勾选参与训练的 GPU。
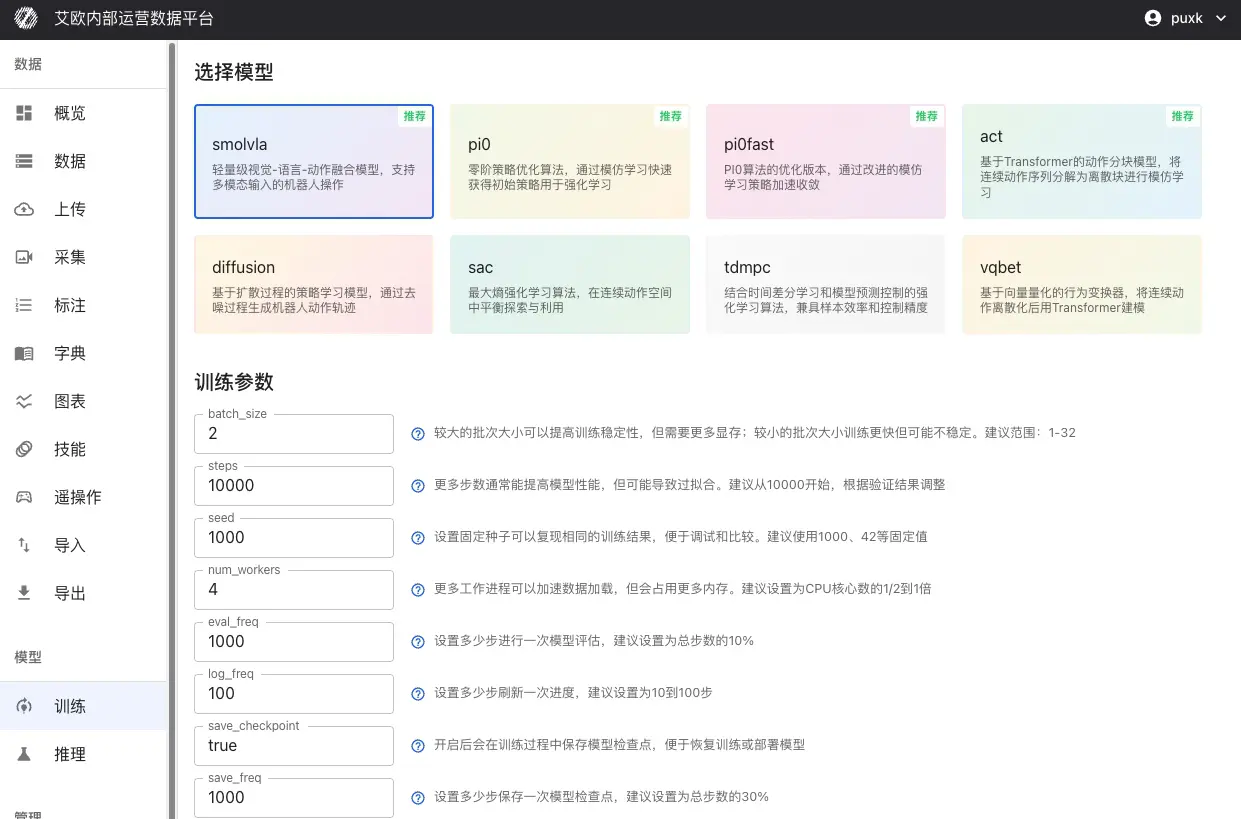
- 选择模型,并在该模型支持的框架中选择训练框架。
- 填写训练参数;首次训练可使用默认值。
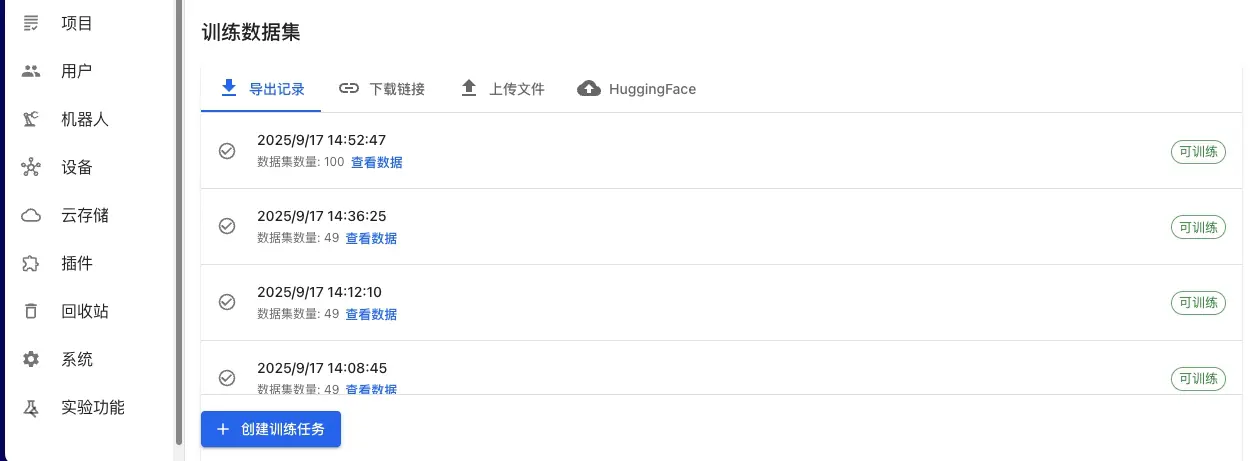
- 选择训练数据集,来源见下表。
- 可选:在「从已有训练继续」中选择源训练任务与检查点权重。
- 选择项目归属;不选择时为私密任务,仅创建者可见。
- 点击「创建训练任务」。
训练数据集的四种来源如下。
| 来源 | 数据位置 | 说明 |
|---|---|---|
| 导出 LeRobot | 平台导出记录 | 从导出历史中选择一条记录 |
| 已上传 LeRobot | 平台数据集 | 选择已上传的 LeRobot 数据集 |
| 下载链接 | 外部地址 | 支持 .tar.gz 或 .zip 格式的 LeRobot 数据集 |
| HuggingFace | HuggingFace Hub | 填写数据集名称,如 io-intelligence/piper_uncap_pen |
训练参数
通用参数
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
batch_size | int | 1 | 每次训练使用的样本数量,按显存调整 |
steps | int | 10000 | 训练总步数 |
seed | int | 1000 | 随机种子,用于结果复现 |
num_workers | int | 4 | 数据加载器工作进程数 |
eval_freq | int | 1000 | 每多少步评估一次 |
log_freq | int | 100 | 每多少步输出一次日志 |
save_checkpoint | bool | 是 | 是否保存检查点 |
save_freq | int | 5000 | 每多少步保存一次检查点 |
模型特定参数
训练页按所选模型显示对应参数。常用模型的默认值如下。
| 模型 | 参数 | 默认值 | 说明 |
|---|---|---|---|
act | chunk_size | 100 | 一次预测的动作序列长度 |
act | n_action_steps | 100 | 每次调用执行的动作步数 |
act | vision_backbone | resnet18 | 视觉主干,可选 resnet18/34/50/101/152 |
act | kl_weight | 10.0 | KL 散度损失权重 |
diffusion | horizon | 16 | 动作预测时间跨度 |
diffusion | n_action_steps | 8 | 每次调用执行的动作步数 |
diffusion | num_inference_steps | 空 | 反向扩散采样步数 |
groot | image_size | 224×224 | 视觉塔输入的图像分辨率 |
groot | max_state_dim | 64 | 状态向量最大维度,不足补零 |
groot | max_action_dim | 32 | 动作向量最大维度,不足补零 |
pi0、pi05 | chunk_size | 50 | 一次预测的动作序列长度 |
pi0、pi05 | num_inference_steps | 10 | 去噪采样步数 |
pi0、pi05 | max_state_dim | 32 | 状态向量最大维度 |
smolvla | chunk_size | 50 | 一次预测的动作序列长度 |
smolvla | num_steps | 10 | 解码步数 |
smolvla | max_state_dim | 32 | 状态向量最大维度 |
sac | discount | 0.99 | 折扣因子 |
sac | actor_lr | 3e-4 | 策略网络学习率 |
tdmpc | horizon | 5 | 预测时间跨度 |
tdmpc | discount | 0.9 | 折扣因子 |
结果校验
训练过程监控
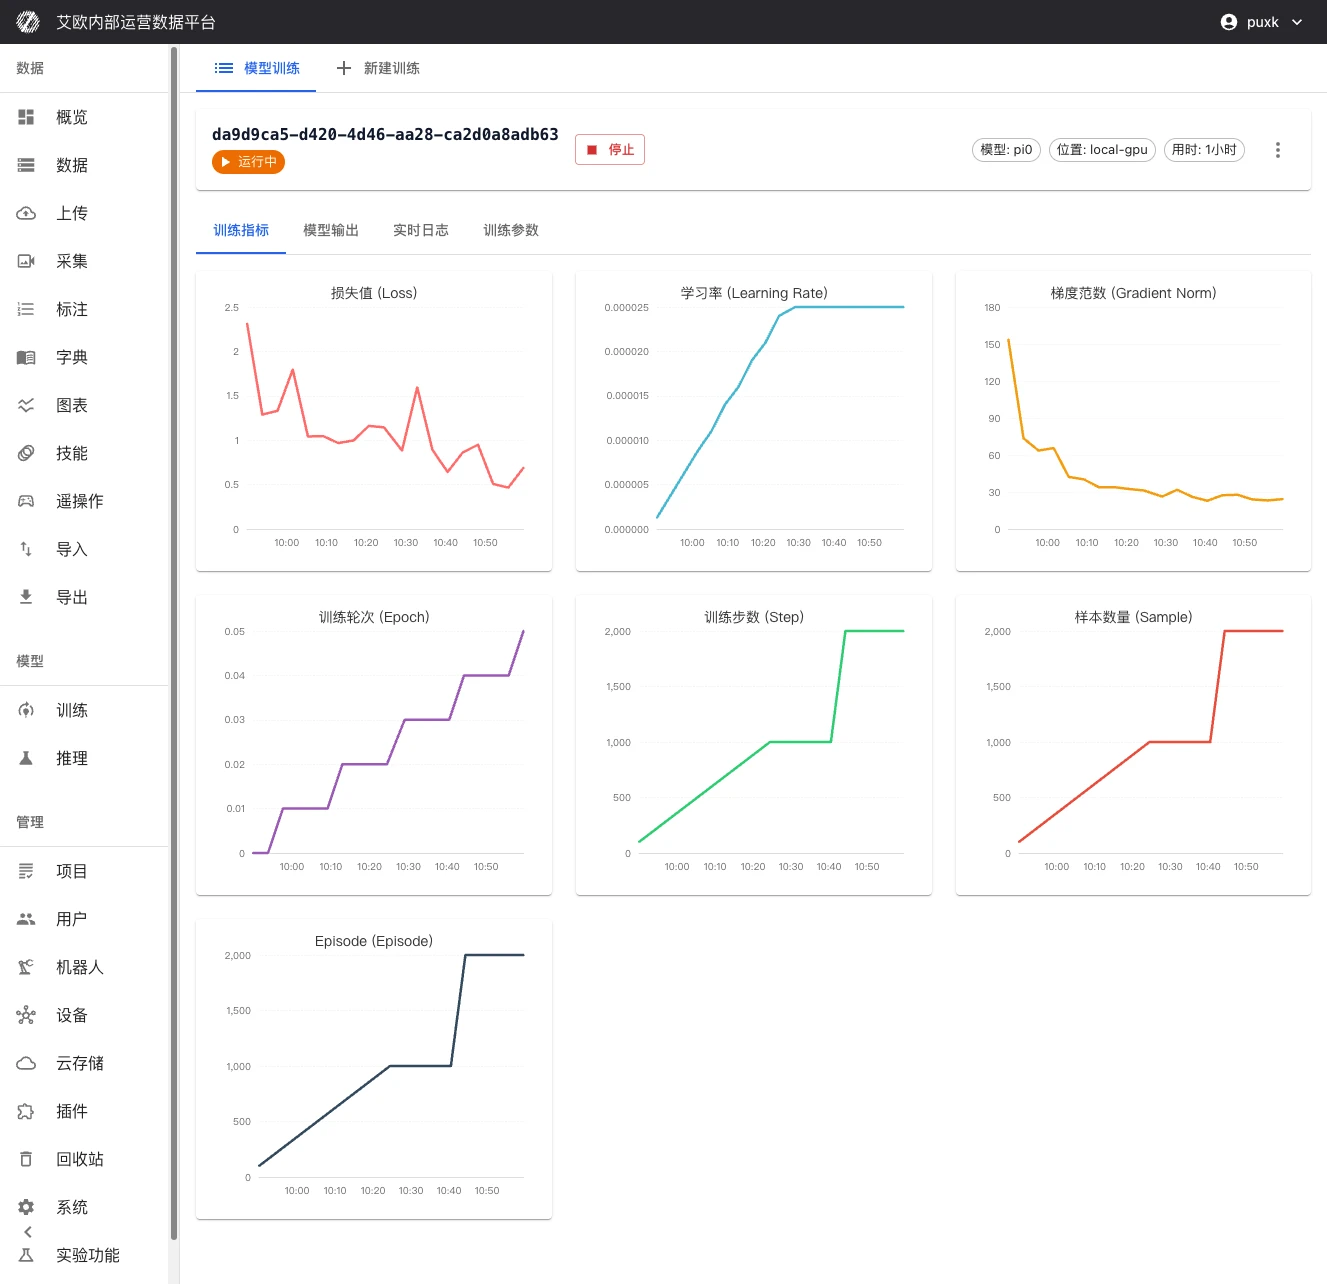
训练详情页提供四个标签页。
| 标签页 | 内容 |
|---|---|
| 训练指标 | 损失曲线、验证指标、学习率与训练进度 |
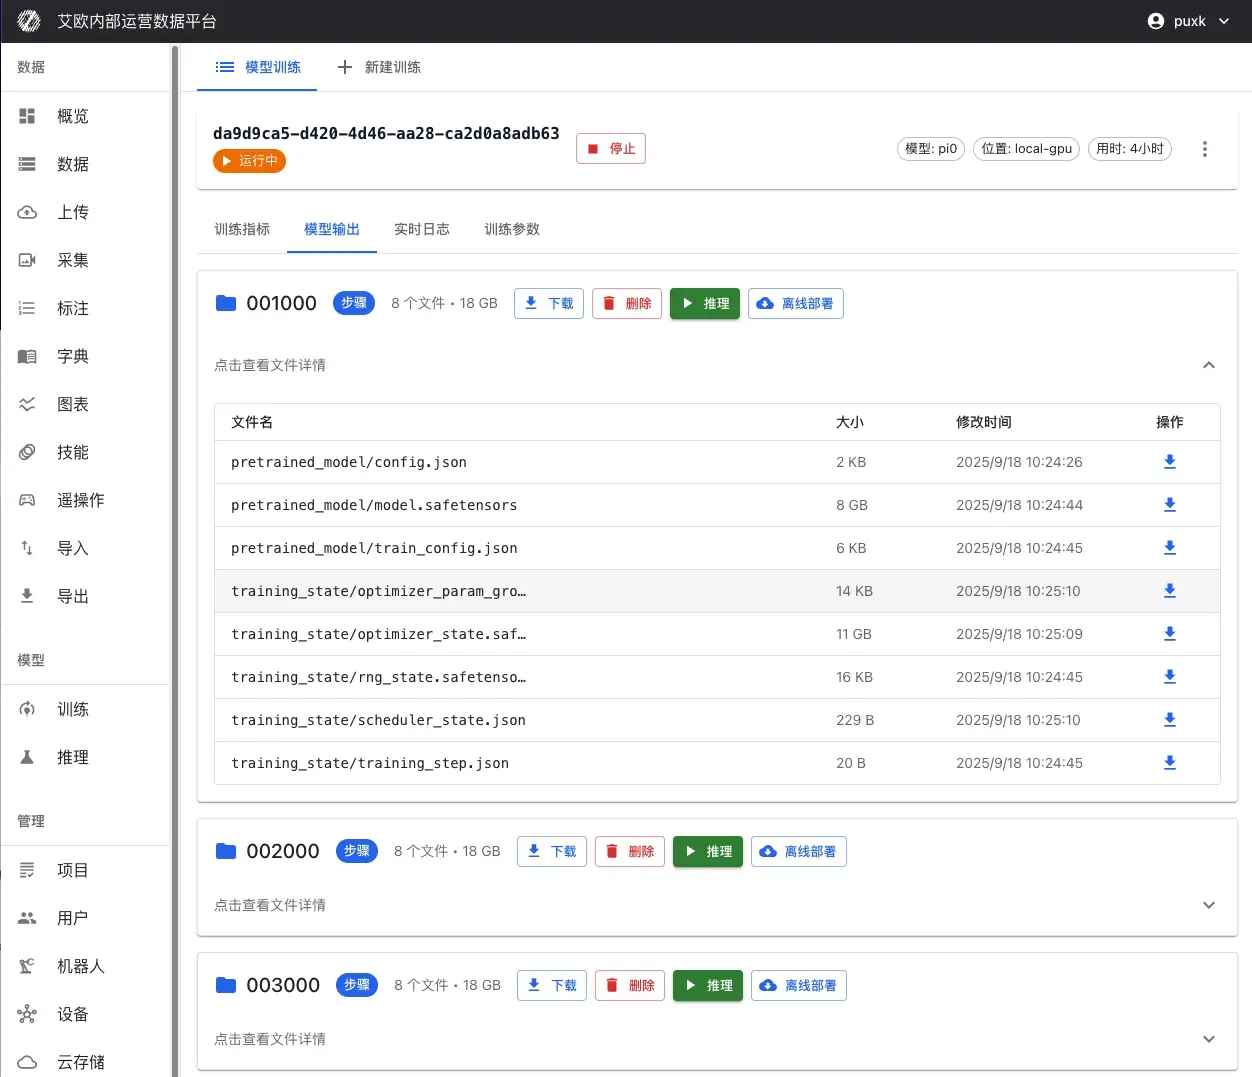
| 模型输出 | 检查点列表与产物文件 |
| 实时日志 | 训练日志的流式输出 |
| 训练参数 | 本次任务采用的参数 |
状态与进度取自训练服务上报的字段:进度百分比、当前步数、总步数、损失值、学习率、GPU 显存占用。
训练任务状态如下。
| 状态 | 含义 | 可执行操作 |
|---|---|---|
| 等待中 | 已创建,等待调度 | 删除 |
| 运行中 | 正在训练 | 停止、删除 |
| 成功 | 训练完成 | 部署推理、删除 |
| 失败 | 训练异常结束 | 从检查点继续、删除 |
| 用户停止 | 由用户手动停止 | 从检查点继续、删除 |
| 已暂停 | 训练暂停 | 停止、删除 |
检查点与产物
检查点按训练步数保存,类型分为最终检查点与步骤检查点。
| 操作 | 作用 | 约束 |
|---|---|---|
| 下载 | 下载检查点文件或整包 | 大检查点可先同步到对象存储再下载 |
| 删除 | 删除检查点 | 不可恢复 |
| 推理 | 从检查点部署推理服务 | 见模型推理 |
| 离线部署 | 生成离线部署包 | 见模型推理 |
「从已有训练继续」用于微调或续训:选择源训练任务与检查点权重后,创建新任务。
| 约束 | 说明 |
|---|---|
| 训练位置一致 | 源训练任务须与目标训练位置位于同一训练节点 |
| 检查点存在 | 仅可选择源任务中实际存在的检查点 |
「训练参数」标签页提供「编辑参数并重新训练」:修改参数后,系统基于当前任务创建一条新训练任务,原任务保持不变。
异常处置
| 现象 | 可能原因 | 处置 |
|---|---|---|
| 无法创建训练任务 | 训练额度用尽、未选择数据集、未选择检查点 | 申请额度;补齐数据集与检查点选择 |
| 训练任务失败 | 显存不足、数据格式错误、参数配置错误 | 降低 batch_size;修正数据格式;调整参数后重新训练 |
| 本机 GPU 不可用 | 无可用 GPU | 系统提示已回退到 CPU 训练;检查 GPU 配置 |
groot 无法选择 GPU | GPU 型号非 Nvidia Ampere 及以上 | 更换为 A100、RTX 4090 等型号 |
| 训练中断 | 训练节点故障 | 从已保存的检查点继续训练 |
| 训练耗时超出预期 | 数据量大、模型参数多、GPU 性能不足 | 减少训练步数或数据量;更换算力更高的 GPU |
相关页面
| 页面 | 用途 |
|---|---|
| 模型推理 | 将检查点部署为推理服务 |
| 数据导出 | 导出 LeRobot 格式训练数据 |
| 数据质检 | ROS 录制的自动质量检测规则 |
| 额度管理 | 训练次数与时长额度的授予与查看 |
| LeRobot 数据集与训练 | LeRobot 数据集的导入、可视化与训练 |